Netflix GenRec:vLLM上のLLMランカーが、ラベルデータ40分の1で成熟推薦を上回った理由
AI研究・推薦システム
NetflixはGenRecの詳細を公開しました。会員履歴をテキスト化し、カタログ対応のスコアリングヘッドで順位付けし、社内LLMスタック上で vLLMのprefill-only配信するLLMベースの推薦ランカーです。長年チューニングされた本番ランカーに対し、オフライン順位は上回り、オンラインでも統計的に有意な改善を示しつつ、Phase-2のラベルデータはごく一部で済みました。
GenRecとは何か、なぜ重要か
従来のNetflix推薦は、数千の手作り密特徴・埋め込み特徴と、系列・特徴交互・マルチタスク向けの専用アーキテクチャに依存してきました。有効ではあるが拡張コストが高く、新しいコンテンツ種別やサーフェス追加は特徴設計、アーキ変更、インフラ、実験の積み上げになりがちです。
GenRecは推薦をLLMネイティブ問題として扱います。履歴・メタデータ・文脈を自然言語プロンプトにし、Netflixデータで適応させた基盤LLMをランキング向けにポストトレーニングします。市販LLM単体では人気バイアスやカタログ外幻覚などが残るため、出力をNetflixカタログに制約し、長期的な会員価値と事業目標へ学習を揃えます。
論文の推論図は、履歴を一度言語化し、単一のprefillパスでスコアする——タイトルを逐次デコードしない——という配信選択を明確に示します。
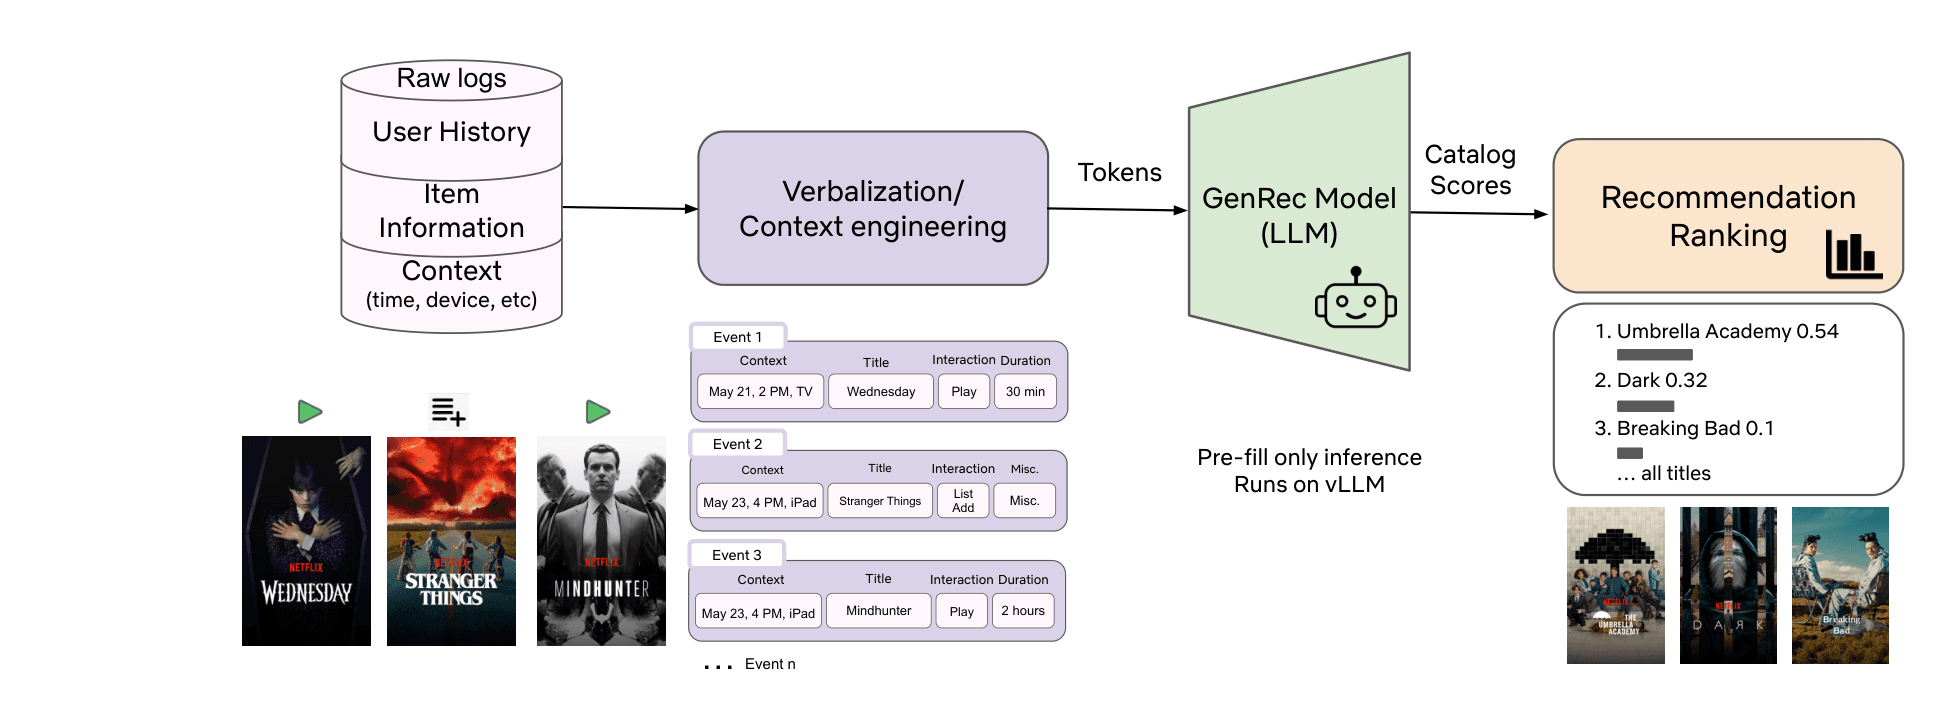
「ユーザー履歴・アイテムメタデータ・文脈の生ログを、コンテキストエンジニアリングにより自然言語プロンプトへ変換し、vLLM上でprefill-only動作するGenRecモデルに入力する。モデルはカタログ全体のスコアを出力し、推薦順位を得る。」— Li et al., GenRec (arXiv:2608.10257), 図1キャプション(訳)
Prefill-onlyが実務の要です。自己回帰的な生成推薦は大規模候補に対して逐トークン復号のコストを払い、GenRecはプロンプトを一度処理したうえでカタログ対応ヘッドで順位付けします——古典的ランキングに近い遅延と、LLM的な文脈理解の両立です。
従来の推薦モデルとの違い
- 特徴エンジニアリング → コンテキストエンジニアリング。 プロンプトが新しい特徴ベクトルになります。
- 専用アーキ → 共有基盤バックボーン。 two-towerやDLRMを一から作り直すのではなく、基盤LLMを共有します。
- ID中心 → 言語化された意味。 視聴やフィードバックをテキスト化し、言語理解を再利用します。
- 逐次生成 → カタログ一括スコアリング。 生成バックボーンでも、本番ではトークン単位のデコードではなく一回のforwardで順位付けします。
二段階学習とカタログ対応スコアリング
Phase 1はOSS LLMをNetflixコーパスで適応させ、更新頻度は低く共有基盤になります。 Phase 2はランキング特化のポストトレーニングで、対話形式の学習データ、ランキング損失、LM損失、長期満足度と事業バランス向けの 報酬重み付き損失を組み合わせます(公開版はフルRLではありません)。
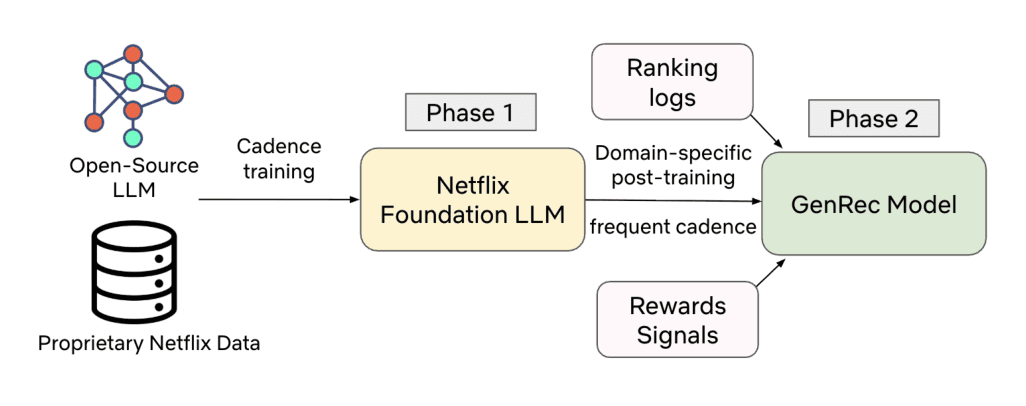
「Phase 1はNetflixデータ上で基盤LLMを訓練しユーザーとコンテンツ理解を養い、Phase 2は推薦ランキング向けのデータと目的でポストトレーニングする。」— Li et al., GenRec (arXiv:2608.10257), 図2キャプション(訳)
これはアーキ図以上に運用リズムの話です。Phase 1は共有で更新が遅いバックボーン、Phase 2は新作・嗜好変化・報酬誘導を取り込む高頻度ランカー——だからPhase-2ラベル削減の方が、Phase-1事前学習をさらに削るより商業的に効きます。
推論では文脈表現をプールし、アイテム埋め込みをスコア化してsoftmaxで順位を得ます。カタログ内制約と大規模候補集合を両立します。
労力・データ効率:Netflixが主張したこと
Netflixは人員削減の人数を公表していません。効率の核心はラベルと特徴作業です。
- 強いPhase-1から出発すると、本番ランカーと同等以上を約 10〜40倍少ないPhase-2ラベルで達成。
- 見出しのオフライン比較では約40倍少ないPhase-2データでもMRRが上回る。
- 手作り入力シグナルが大幅に減り、カタログ成長に伴う特徴インフラ負担が軽くなる。
Phase 2はPhase 1より更新頻度が高いため、ラベル削減と特徴パイプライン削減こそが実質的な「労力削減」です。
オフラインとオンライン評価
オフライン:本番比でMRRが相対約+1.6%改善(Phase-2ラベル約40分の1)。データとシグナルを増やすとさらに改善。
アブレーションでは、Netflix適応のPhase-1が市販LLM直結よりオフラインで約10〜20%優位、Phase-2がさらに大きく寄与(カットオフ付近で約35〜50%)。
オンライン:バッチ計算サーフェスで約トラフィックの10%、約4週間のA/B。低データ設定でも短期・長期指標がともに 統計的に有意。論文はコア長期指標で相対約+0.006%を例示。二次報道では短期約+0.115%も言及。
数値は小さく見えますが、Netflix規模では統計的に有意になり得ます——Netflix自身の表現です。公開記事にp値や信頼区間はありません。論点は巨大な絶対ジャンプではなく、少ないPhase-2監督で長年の基線を上回ったことです。
サービングコストは上がったのか?
コストは最重要制約です。NetflixはGenRecが旧来ランカーより絶対額で安いとは言っていません。LLMは重いが、数億会員規模で予算内に収めることが目標です。
- 小型/蒸留バックボーン
- コンテキスト圧縮(約5,000→1,700トークン、約1/3)。GenRec自身のサービングコストも約1/3へ
- Prefill-only:カタログに対する逐次デコードを避け、一回のforwardでスコアリング
結論:GenRecの配信コストは積極的に圧縮された一方、旧ランカーとの「高い/安い」の単純比較は未公開です。
AIアプリケーションへの示唆
- 共有基盤モデル+強いドメインポストトレーニング/報酬
- コンテキストエンジニアリングが一級スキルに
- vLLM等のLLMインフラが従来RecSys負荷を吸収し始める
- スケーリング則が設計指針に(コストPareto内)
- 公開A/Bはバッチ計算サーフェスに限定——全サーフェス置換の主張ではない
パーソナライズやランキングを作るチームへの実務メッセージは明確です。数千の手作り特徴がなくても成熟基線を超え得る一方、ドメイン適応・カタログ制約・報酬整合・不要なデコードを払わない配信設計は不可欠です。