Netflix GenRec:用 vLLM 上的 LLM 排序器,以 40 倍更少標註資料擊敗成熟推薦系統
AI 研究與推薦系統
Netflix 近日公開 GenRec 的細節——這是一套以 LLM 為後盾的推薦排序器:把會員歷程寫成文字、用 catalog-aware 評分頭對片庫打分,並在 Netflix 內部 LLM 堆疊上以 vLLM 的 prefill-only 模式提供服務。對上多年調校的成熟正式排序器,GenRec 在離線排序更強、線上提升達統計顯著,且只用了少得多的 Phase-2 標註資料。
GenRec 是什麼?為什麼重要?
傳統 Netflix 推薦依賴數千個手工密特徵與嵌入特徵,再加上序列、特徵交互與多任務等專用架構。這套系統有效,但擴展成本高:新內容類型或新產品面,往往意味著更多特徵工程、架構改動、基礎設施與實驗。
GenRec 押注另一條路:把推薦當成 LLM 原生問題。使用者歷程、內容 metadata 與情境變成自然語言提示;內部基礎 LLM 先在 Netflix 資料上適配,再針對排序做後訓練,學習以往靠特徵工程手工設計的交互。現成 LLM 仍不夠(熱門偏誤、館外幻覺、個人化弱),因此 GenRec 把輸出限制在 Netflix 片庫,並用長期會員價值與商業目標對齊訓練。
論文的推論圖把服務策略講得很清楚:歷程先文字化,再以單次 prefill 打分——而不是逐個標題解碼。
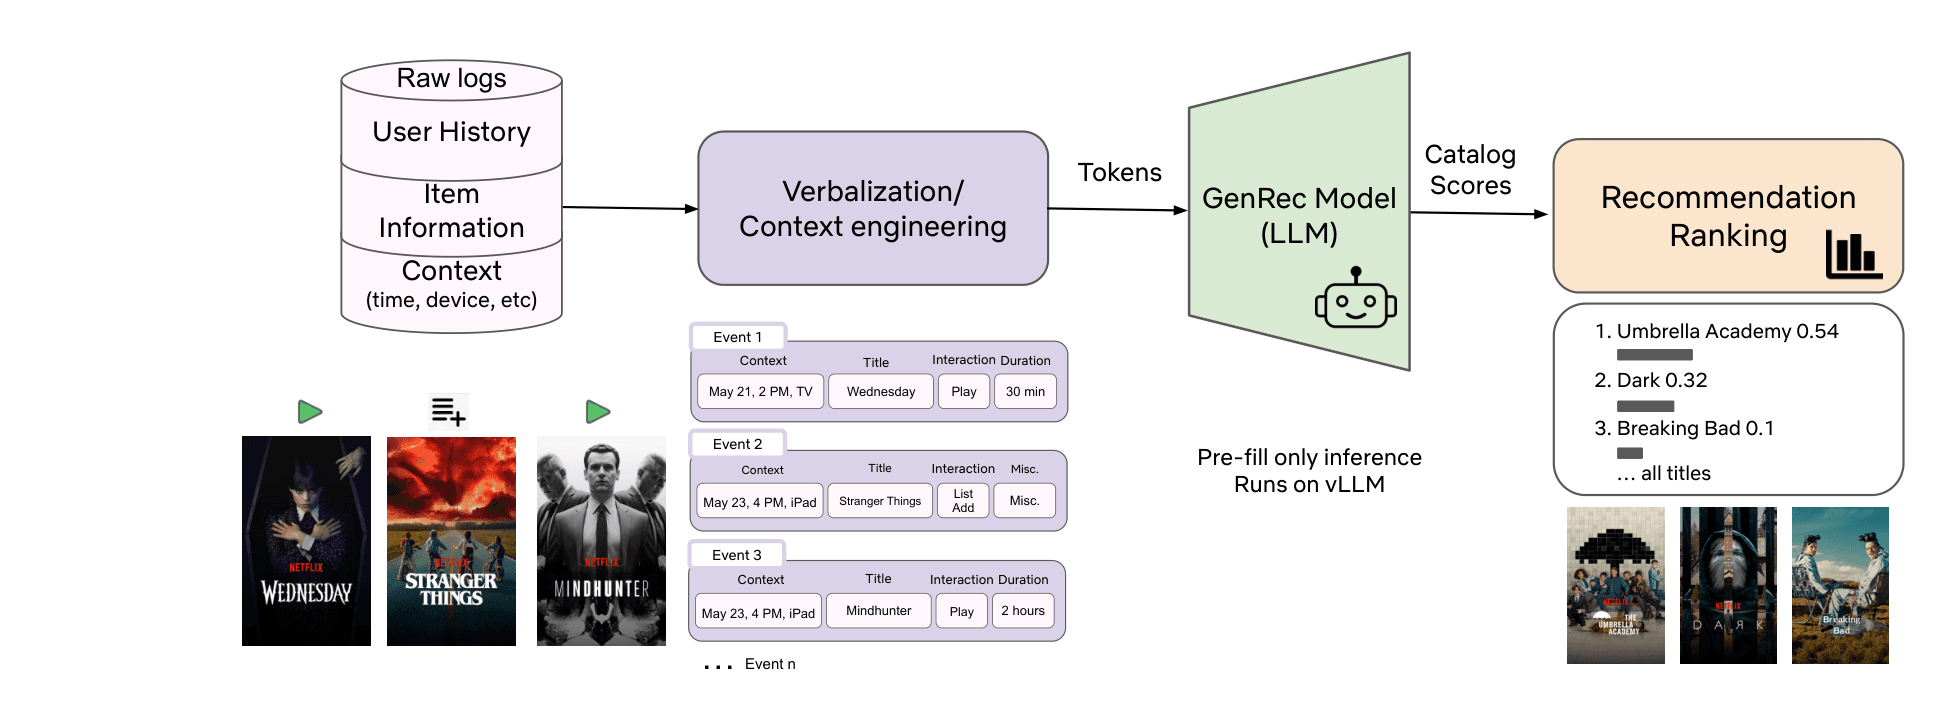
「使用者歷史、內容 metadata 與情境等原始日誌,經情境工程轉成自然語言提示,送入在 vLLM 上以 prefill-only 模式運行的 GenRec 模型,一次輸出整館分數並形成推薦排序。」— Li 等,GenRec(arXiv:2608.10257),圖 1 說明(譯文)
Prefill-only 才是實務關鍵:自回歸生成式推薦要對大型候選集逐 token 解碼;GenRec 只對提示算一次,再用 catalog-aware 頭排序——延遲更接近經典排序,語意則走 LLM 情境。
與傳統推薦模型有何不同?
- 特徵工程 → 情境工程。提示詞就是新的特徵向量:決定保留哪些事件、回看多久、如何在 token 預算內壓縮歷史。
- 專用架構 → 共享基礎骨幹。GenRec 共用 Netflix 基礎 LLM,而不是再從零做一座 two-tower / DLRM。
- ID 密集 → 語義文字化。播放、拇指、metadata 與情境寫成文字,重用語言理解與內容知識。
- 逐 token 生成 → 一次打分整館。雖是生成式骨幹,上線並不逐字解碼推薦;catalog-aware 評分頭一次前向即可排序。
兩階段訓練與 Catalog-Aware 評分
Phase 1 在專有 Netflix 語料上適配開源 LLM,建立內容與會員行為理解,更新較慢,作為共享骨幹。
Phase 2 針對排序做後訓練:從互動日誌建對話式資料、對高價值互動做排序目標、保留語言模型目標,並用 reward-weighted loss 對齊長期滿意度與內容類型平衡——公開系統並未依賴完整 RL。
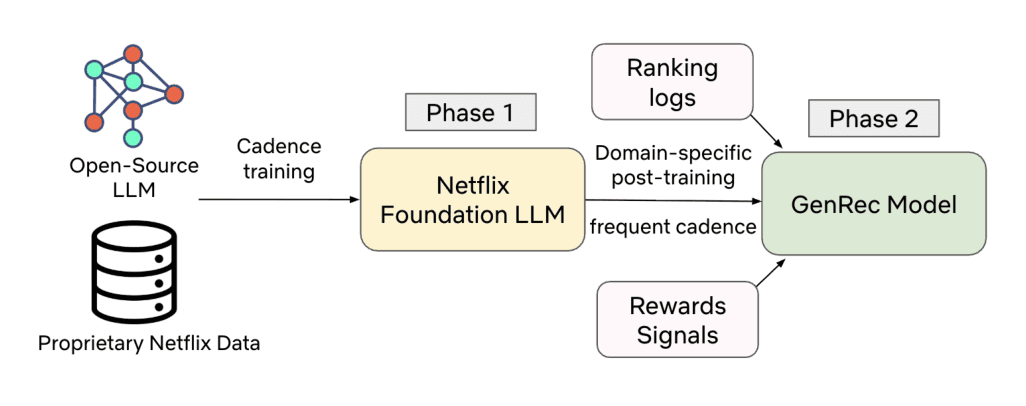
「Phase 1 在 Netflix 資料上訓練基礎 LLM,建立使用者與內容理解;Phase 2 再針對推薦排序專用資料與目標做後訓練。」— Li 等,GenRec(arXiv:2608.10257),圖 2 說明(譯文)
這是運作節奏上的分工,不只是架構圖:Phase 1 是共享、更新較慢的骨幹;Phase 2 才是高頻排序器,吸收新片、口味變化與獎勵導向——所以壓縮 Phase-2 標註,比再砍 Phase-1 預訓練更有商業意義。
推論時對文字情境做 pooled 表示,再對 item embedding 打分,softmax 轉成排序,確保館內推薦並支援大型候選集。
人力與資料效率:Netflix 實際說了什麼?
Netflix 沒有公布節省多少 FTE。效率敘事聚焦在標註與特徵工作:
- 從強 Phase-1 出發,GenRec 以約 10–40 倍更少的 Phase-2 標註樣本即可追平或超越正式排序器。
- 頭條離線比較約 40 倍更少 Phase-2 資料,MRR 仍優於成熟基線。
- 手工輸入訊號大幅減少,片庫與產品面成長時特徵基礎設施負擔較輕。
這點商業上很關鍵:Phase 2 刷新頻率高於 Phase 1。減少標註排序資料與特徵管線,才是 Netflix 真正指向的「勞動節省」。
離線與線上評估
離線:相對正式排序器,MRR 約提升 +1.6%,同時只用約 40 倍更少的 Phase-2 標註與更少輸入訊號;擴大資料與情境後指標持續上升。
消融顯示:Netflix 適配的 Phase-1 比直接從現成 LLM 起步,離線排序約優 10–20%;Phase-2 再帶來大幅提升(接近 Phase-1 截止時約 35–50%,隨 Phase-1 老化更明顯)。
線上:在批次計算推薦面做大型 A/B,約佔 Netflix 流量 10%、為期約 4 週。低資料/低訊號設定下,短期與長期指標皆達 統計顯著。論文提到核心長期指標約 +0.006% 相對提升;二手報導也提到短期約 +0.115%。
百分比看起來很小,但在 Netflix 規模下仍可具統計顯著性——這是 Netflix 自己的表述——因為樣本極龐大。成熟推薦系統常以極小相對提升競爭;重點不是巨大絕對跳升,而是用遠少的 Phase-2 監督擊敗多年調校基線。公開文章未提供 p 值或信賴區間。
服務成本有沒有上升?
服務成本是一級約束。Netflix 並未宣稱 GenRec 在絕對美元上比經典 MLP/特徵排序器更便宜。LLM 骨幹更重;工程目標是在數億會員規模下讓 LLM 排序落在算力預算內。
GenRec 跑在內部 LLM 堆疊的 vLLM 上。成本大致與模型大小 × 情境長度成正比,透過三個槓桿控制:
- 更小/蒸餾骨幹,用更多或更精準資料換回品質。
- 情境壓縮:約從 5,000 token 壓到 1,700(約三分之一),離線 MRR 幾乎不掉,GenRec 自身服務成本約降到三分之一。
- Prefill-only:不對片庫做逐 token 解碼;讀一次提示、一次前向打分候選——相對自回歸生成式推薦至關重要。
結論:GenRec 的服務成本被主動壓低;與舊排序器「更貴或更便宜」的乾淨對比並未公開。
對 AI 應用的意涵
- 共享基礎模型在領域後訓練與獎勵夠強時,可取代任務專用塔。
- 情境工程成為一級產品技能——放進提示的內容與模型大小同樣關鍵。
- LLM 服務基礎設施(vLLM、GPU、prefix cache、batching)開始承接過去屬於經典 RecSys 的負載。
- 擴展定律成為設計指南:在成本 Pareto 內,更多 Phase-2 資料與更大骨幹單調提升品質。
- 但:公開 A/B 證據在批次計算推薦面,並非宣稱所有 Netflix 排序面都已上 GenRec。
對做個人化、搜尋排序或內容動態牆的團隊來說:你或許不需要數千個手工特徵才能擊敗成熟基線——但你需要領域適配、館內約束、獎勵對齊,以及拒絕為不必要解碼付帳的服務方案。