Netflix GenRec: vLLM 위 LLM 랭커가 라벨 데이터 40배 적게 쓰고도 성숙 추천을 이긴 이유
AI 연구 & 추천 시스템
Netflix가 GenRec을 자세히 공개했습니다. 회원 이력을 텍스트로 만들고, 카탈로그 인식 스코어링 헤드로 순위를 매기며, 내부 LLM 스택에서 vLLM prefill-only로 서빙하는 LLM 기반 추천 랭커입니다. 수년간 튜닝된 프로덕션 랭커 대비 오프라인 순위가 더 좋고, 온라인에서도 통계적으로 유의한 개선을 냈으며 Phase-2 라벨 데이터는 훨씬 적게 썼습니다.
GenRec이란, 왜 중요한가
기존 Netflix 추천은 수천 개의 수작업 dense·임베딩 특징과 시퀀스, 특징 상호작용, 멀티태스크용 전용 아키텍처에 의존합니다. 잘 동작하지만 확장 비용이 큽니다. 새 콘텐츠 유형이나 서페이스를 추가할 때마다 특징 엔지니어링, 아키텍처, 인프라, 실험이 따라옵니다.
GenRec은 추천을 LLM 네이티브 문제로 봅니다. 이력· 메타데이터·컨텍스트를 자연어 프롬프트로 만들고, Netflix 데이터로 적응시킨 파운데이션 LLM을 랭킹용으로 후학습합니다. 기성 LLM만으로는 인기 편향·카탈로그 밖 환각·약한 개인화가 남으므로, 출력을 Netflix 카탈로그로 제한하고 장기 회원 가치·비즈니스 목표에 맞춥니다.
논문의 추론 다이어그램은 서빙 선택을 분명히 합니다. 이력을 한 번 언어화한 뒤 단일 prefill 패스로 점수를 매기며, 제목을 하나씩 디코딩하지 않습니다.
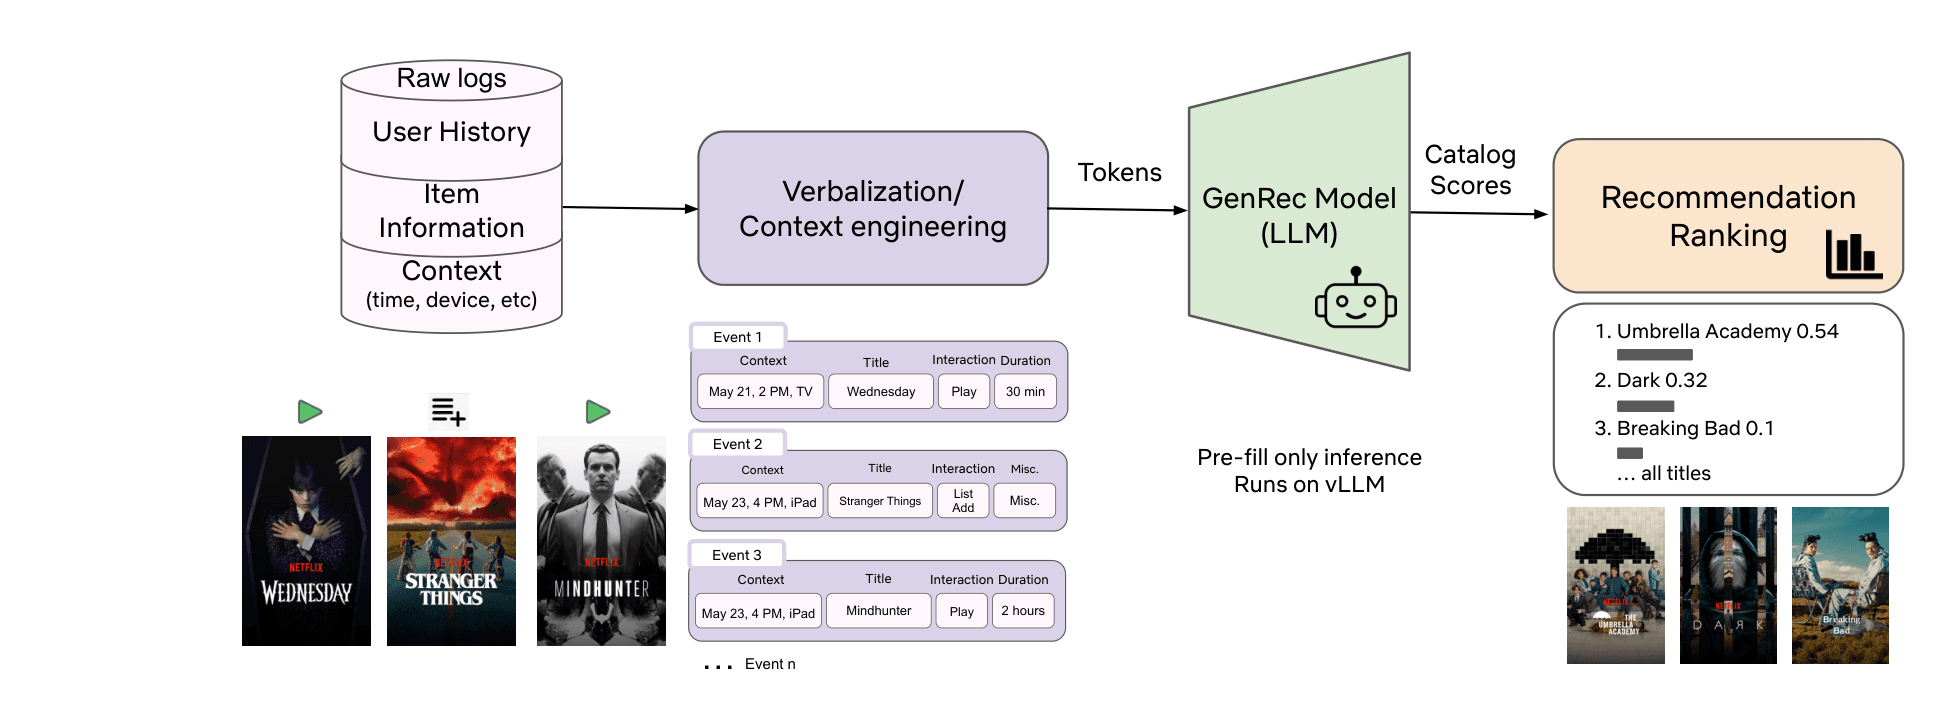
「사용자 이력·아이템 메타데이터·컨텍스트의 원시 로그를 컨텍스트 엔지니어링으로 자연어 프롬프트로 바꾼 뒤, vLLM에서 prefill-only로 동작하는 GenRec 모델에 넣는다. 모델은 전체 카탈로그 점수를 내어 추천 순위를 만든다.」— Li et al., GenRec (arXiv:2608.10257), 그림 1 캡션(번역)
Prefill-only가 실무의 핵심입니다. 자기회귀 생성형 추천은 대규모 후보에 토큰 단위 디코딩 비용을 치르고, GenRec은 프롬프트를 한 번 처리한 뒤 카탈로그 인식 헤드로 순위를 냅니다—고전 랭킹에 가까운 지연과 LLM식 컨텍스트를 함께 취합니다.
전통 추천 모델과 무엇이 다른가
- 특징 엔지니어링 → 컨텍스트 엔지니어링. 프롬프트가 새로운 특징 벡터입니다.
- 전용 아키텍처 → 공유 파운데이션 백본. two-tower/DLRM을 처음부터 새로 짓지 않습니다.
- ID 중심 → 언어화된 의미. 시청·피드백을 텍스트로 표현해 언어 이해를 재사용합니다.
- 토큰 생성 → 카탈로그 일괄 스코어링. 생성 백본이어도 서빙 시 토큰 단위 디코딩 없이 한 번의 forward로 순위를 냅니다.
2단계 학습과 카탈로그 인식 스코어링
Phase 1은 오픈소스 LLM을 Netflix 코퍼스로 적응시켜 공유 백본이 됩니다. Phase 2는 랭킹 후학습으로, 대화형 학습 데이터·랭킹 손실·LM 손실·장기 만족과 콘텐츠 균형용 보상 가중 손실을 씁니다(공개 시스템은 전체 RL이 아님).
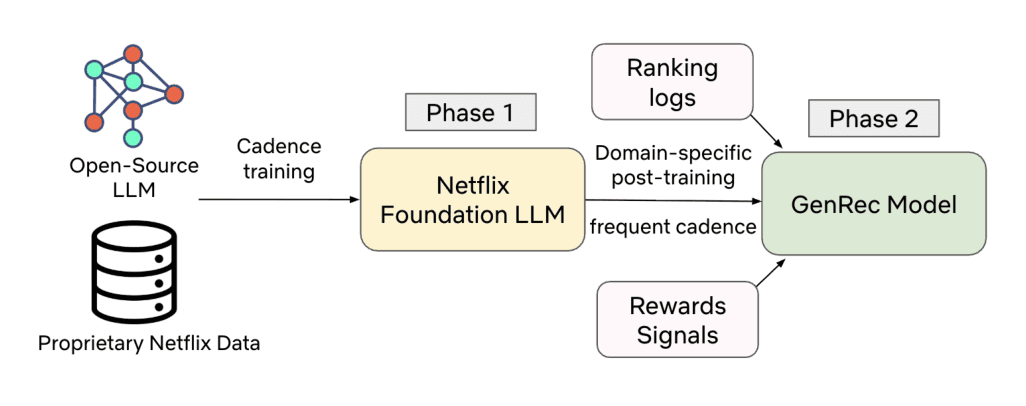
「Phase 1은 Netflix 데이터로 파운데이션 LLM을 학습해 사용자·콘텐츠 이해를 키우고, Phase 2는 추천 랭킹 전용 데이터와 목표로 후학습한다.」— Li et al., GenRec (arXiv:2608.10257), 그림 2 캡션(번역)
아키텍처 그림 이상의 운영 리듬입니다. Phase 1은 공유·저빈도 백본이고, Phase 2는 신작·취향 변화·보상 조향을 흡수하는 고빈도 랭커입니다—그래서 Phase-2 라벨을 줄이는 편이 Phase-1 사전학습을 더 깎는 것보다 상업적으로 중요합니다.
추론에서는 컨텍스트를 pool한 뒤 아이템 임베딩을 점수화하고 softmax로 순위를 얻습니다. 카탈로그 내 추천과 대규모 후보 집합을 동시에 지원합니다.
노동·데이터 효율: Netflix가 실제로 말한 것
Netflix는 절감 인원 수를 공개하지 않았습니다. 효율 이야기는 라벨과 특징 작업에 있습니다.
- 강한 Phase-1에서 시작해 약 10–40배 적은 Phase-2 라벨로 프로덕션 랭커와 동등 이상.
- 헤드라인 오프라인 비교에서 약 40배 적은 Phase-2 데이터로도 MRR이 더 높음.
- 수작업 입력 신호가 크게 줄어 카탈로그·서페이스 성장 시 특징 인프라 부담이 가벼워짐.
Phase 2는 Phase 1보다 자주 갱신되므로, 라벨·특징 파이프라인 절감이 실질적인 ‘노동 절감’입니다.
오프라인·온라인 평가
오프라인: 프로덕션 대비 MRR 상대 약 +1.6% (Phase-2 라벨 ~40배 감소). 데이터·시그널을 늘리면 지표가 계속 상승.
어블레이션: Netflix 적응 Phase-1이 기성 LLM 직결 대비 오프라인 약 10–20% 우위, Phase-2가 추가로 큰 기여(컷오프 근처 약 35–50%).
온라인: 배치 컴퓨트 서페이스에서 약 트래픽 10%, 약 4주 A/B. 저데이터 설정에서도 단기·장기 지표가 모두 통계적으로 유의. 논문은 핵심 장기 지표 상대 약 +0.006%를 예시. 2차 보도는 단기 약 +0.115%도 언급.
퍼센트는 작아 보이지만 Netflix 규모에서는 통계적으로 유의할 수 있습니다—Netflix 자신의 표현입니다. 공개 글에 p-value나 신뢰구간은 없습니다. 포인트는 거대한 절대 점프가 아니라, 훨씬 적은 Phase-2 감독으로 수년 튜닝 베이스라인을 이긴 것입니다.
서빙 비용은 올랐나?
서빙 비용은 1급 제약입니다. Netflix는 GenRec이 구형 MLP/특징 랭커보다 절대 금액으로 싸다고 말하지 않았습니다. LLM은 무겁고, 목표는 수억 회원 규모에서 예산 안에 넣는 것입니다.
- 더 작은/증류 백본
- 컨텍스트 압축(약 5,000→1,700 토큰, 약 1/3). GenRec 자체 서빙 비용도 약 1/3로 감소
- Prefill-only: 카탈로그에 대한 토큰 디코딩 없이 한 번 읽고 한 번 forward로 점수화
결론: GenRec 서빙 비용은 적극 압축됐고, 구형 랭커 대비 ‘더 비싸다/싸다’의 깔끔한 비교는 공개되지 않았습니다.
AI 애플리케이션에 주는 함의
- 공유 파운데이션 + 강한 도메인 후학습/보상
- 컨텍스트 엔지니어링이 1급 제품 역량
- vLLM 등 LLM 인프라가 기존 RecSys 부하를 흡수하기 시작
- 스케일링 법칙이 설계 가이드(비용 Pareto 내)
- 공개 A/B는 배치 컴퓨트 서페이스에 한정—전면 교체 주장 아님
개인화·검색 랭킹·피드 팀에게 실무 메시지는 분명합니다. 수천 개 수작업 특징 없이도 성숙 베이스라인을 이길 수 있지만, 도메인 적응·카탈로그 제약·보상 정렬·불필요한 디코딩을 거부하는 서빙 설계는 필수입니다.